Masalah Inti RAG Klasik: Chunk Kehilangan Konteks
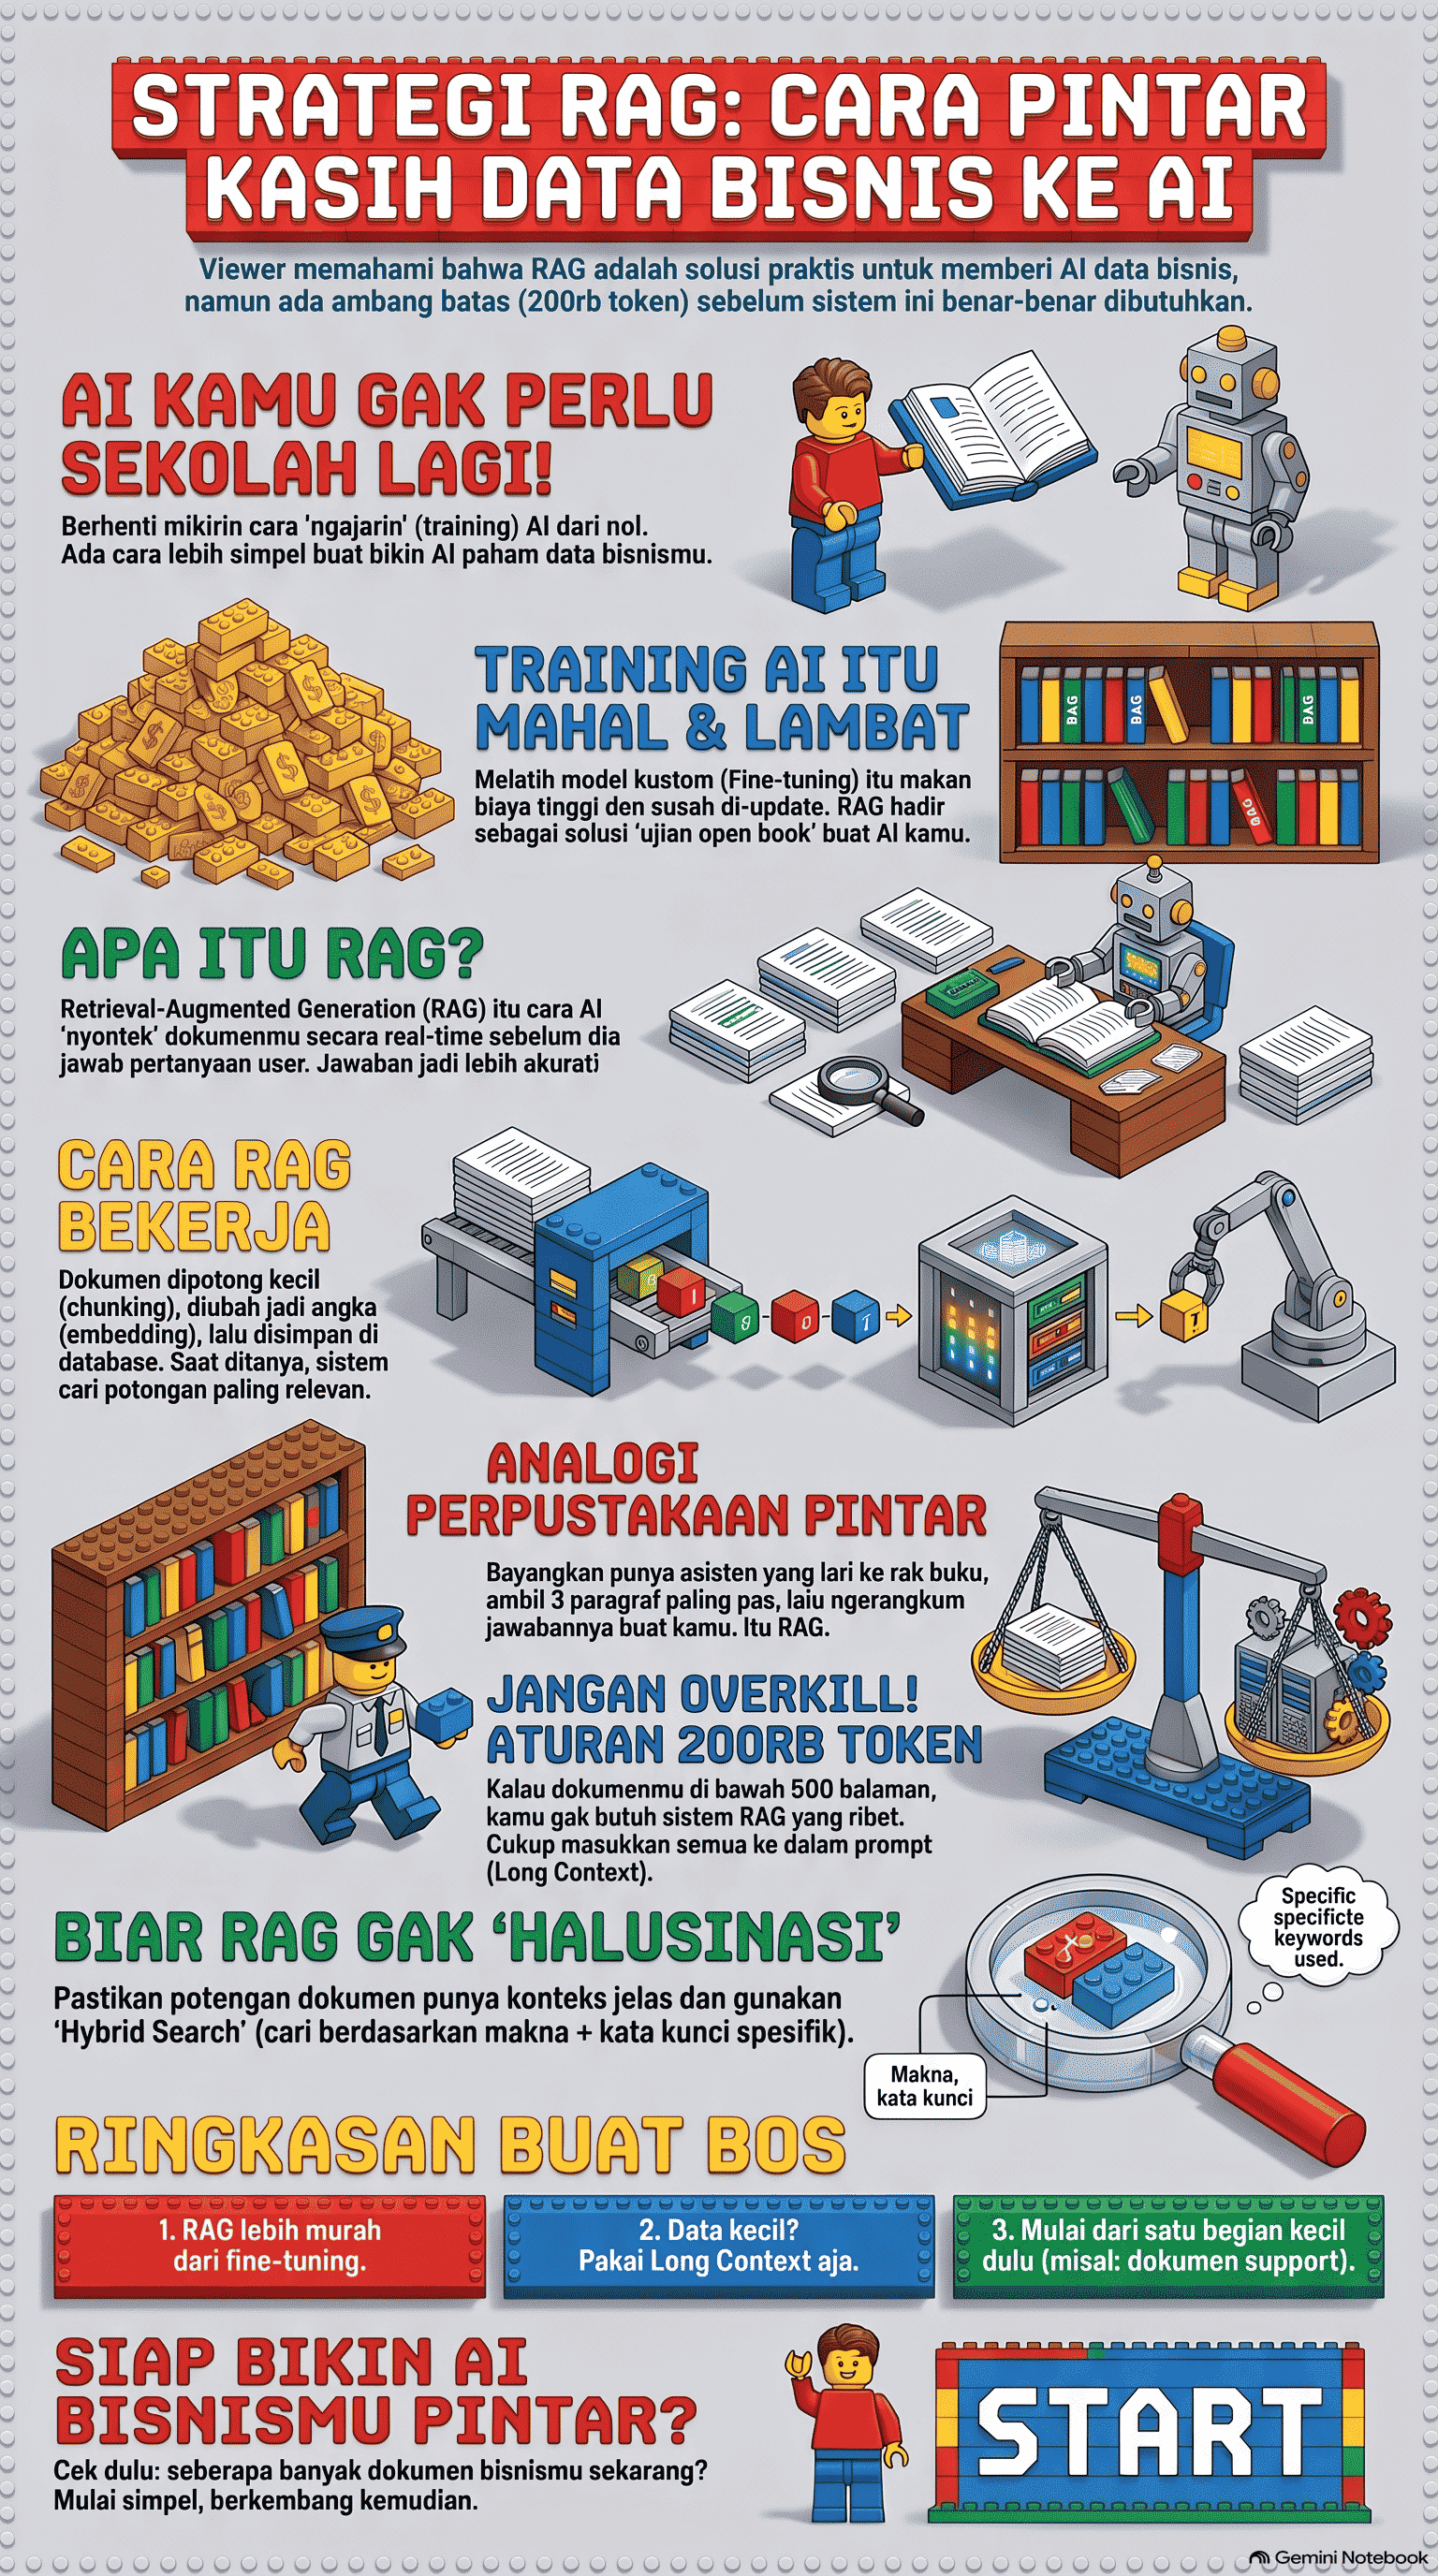
Jika kamu sudah membangun sistem Retrieval-Augmented Generation (RAG) dan merasa akurasinya 'segitu-segitu aja' meskipun embedding model-nya sudah bagus, kemungkinan besar masalahnya bukan di model, tapi di cara dokumen dipecah menjadi chunk.
RAG klasik bekerja dengan memecah dokumen menjadi potongan-potongan kecil (biasanya beberapa ratus token), mengubahnya menjadi vector embedding, lalu menyimpannya di vector database untuk pencarian berbasis kemiripan semantik. Masalahnya: begitu sebuah chunk dipisahkan dari dokumen induknya, ia kehilangan konteks penting.
Contoh klasik dari Anthropic: bayangkan kamu punya knowledge base berisi laporan keuangan SEC filing, dan pertanyaannya adalah 'Berapa pertumbuhan revenue ACME Corp di Q2 2023?' Chunk yang relevan mungkin hanya berisi kalimat:
Revenue perusahaan tumbuh 3% dari kuartal sebelumnya.
Kalimat ini benar secara faktual, tapi tidak menyebutkan perusahaan mana atau periode kapan. Model retrieval kesulitan mencocokkan chunk ini dengan query pengguna, dan bahkan jika berhasil ditemukan, LLM generator bisa salah menafsirkannya tanpa konteks tambahan.
Contextual Embeddings: Menambahkan Ringkasan Konteks di Depan Chunk
Solusi yang diperkenalkan Anthropic disebut Contextual Retrieval, dan komponen pertamanya adalah Contextual Embeddings. Idenya sederhana tapi efektif: sebelum sebuah chunk di-embed, tambahkan penjelasan singkat yang menempatkan chunk tersebut dalam konteks dokumen keseluruhan.
Misalnya, chunk asli:
Revenue perusahaan tumbuh 3% dari kuartal sebelumnya.
Diubah menjadi versi kontekstual:
Chunk ini berasal dari SEC filing performa ACME Corp Q2 2023; revenue kuartal sebelumnya adalah $314 juta. Revenue perusahaan tumbuh 3% dari kuartal sebelumnya.
Untuk menghasilkan konteks ini secara otomatis pada ribuan atau jutaan chunk, Anthropic menggunakan Claude dengan prompt yang menerima seluruh dokumen dan satu chunk spesifik, lalu diminta menghasilkan konteks singkat (biasanya 50-100 token) yang menjelaskan posisi chunk tersebut dalam dokumen. Teks kontekstual ini kemudian disisipkan di depan chunk sebelum proses embedding dan sebelum pembuatan indeks BM25.
Dalam eksperimen Anthropic di berbagai domain (codebase, fiksi, paper ArXiv, paper sains), Contextual Embeddings saja berhasil menurunkan failure rate retrieval top-20-chunk sebesar 35% (dari 5.7% menjadi 3.7%).
Contextual BM25: Menggabungkan Pencarian Semantik dan Keyword
Embedding model unggul menangkap makna semantik, tapi sering gagal pada exact match — misalnya kode error spesifik seperti 'TS-999' atau istilah teknis yang jarang muncul. Di sinilah BM25 (Best Matching 25) berperan, teknik ranking berbasis lexical matching yang membangun di atas konsep TF-IDF, dengan mempertimbangkan panjang dokumen dan fungsi saturasi terhadap frekuensi term.
Contextual BM25 menerapkan prinsip yang sama seperti Contextual Embeddings: konteks yang sama yang disisipkan sebelum embedding juga disisipkan sebelum membangun indeks BM25. Hasilnya, pencarian keyword pun menjadi lebih akurat karena term-term penting (nama perusahaan, tanggal, kode) yang tadinya hilang saat chunking, kini tetap ada di indeks BM25.
Ketika hasil dari kedua metode ini digabung menggunakan rank fusion dan deduplikasi, sistem retrieval bisa memanfaatkan kekuatan pencarian semantik sekaligus presisi exact-match.
Efek Gabungan dan Reranking
Berikut ringkasan hasil eksperimen Anthropic terhadap tingkat kegagalan retrieval top-20-chunk:
| Teknik | Failure Rate | Penurunan |
|---|---|---|
| Baseline (embeddings only) | 5.7% | - |
| Contextual Embeddings | 3.7% | 35% |
| Contextual Embeddings + Contextual BM25 | 2.9% | 49% |
| Contextual Embeddings + BM25 + Reranking | 1.9% | 67% |
Langkah reranking bekerja dengan mengambil kandidat chunk dalam jumlah besar dari initial retrieval (Anthropic menggunakan top 150), lalu melewatkannya bersama query pengguna ke reranking model (mereka menguji Cohere reranker) untuk memberi skor relevansi pada tiap chunk, dan hanya top-K (top 20) yang akhirnya masuk ke prompt LLM.
Kombinasi Contextual Embeddings, Contextual BM25, dan reranking inilah yang menghasilkan klaim penurunan failure rate hingga 67% — dari 5.7% menjadi hanya 1.9%. Untuk developer, ini berarti jauh lebih sedikit kasus di mana informasi yang relevan sebenarnya ada di knowledge base tapi gagal muncul di top-K hasil retrieval.
Perlu dicatat, reranking menambah latency runtime karena ada langkah scoring tambahan, meski scoring dilakukan paralel untuk semua chunk. Ada trade-off antara reranking lebih banyak chunk untuk akurasi lebih baik versus reranking lebih sedikit untuk latency dan biaya lebih rendah — sebaiknya diuji sesuai kebutuhan use case masing-masing.
Trade-off Biaya: Satu Panggilan LLM per Chunk
Konsekuensi paling jelas dari Contextual Retrieval adalah biaya komputasi saat indexing: setiap chunk butuh satu panggilan LLM untuk menghasilkan teks kontekstualnya, dan LLM itu perlu 'melihat' seluruh dokumen agar konteksnya akurat. Untuk knowledge base dengan jutaan chunk, ini bisa jadi mahal jika dilakukan naif — mengirim seluruh dokumen berulang kali untuk tiap chunk yang berbeda.
Solusinya adalah prompt caching. Dengan prompt caching, dokumen referensi hanya perlu dimuat ke cache satu kali, lalu setiap panggilan berikutnya untuk chunk lain dalam dokumen yang sama cukup mereferensikan konten yang sudah di-cache tersebut — tidak perlu mengirim ulang seluruh dokumen dari nol. Dengan asumsi chunk 800 token, dokumen 8.000 token, instruksi konteks 50 token, dan output konteks 100 token per chunk, biaya satu kali generate contextualized chunks menjadi sekitar $1.02 per satu juta token dokumen.
Biaya ini adalah biaya satu kali saat proses indexing, bukan biaya per query saat runtime — jadi meskipun terlihat menambah kompleksitas pipeline, dampaknya terhadap biaya operasional jangka panjang relatif kecil dibanding manfaat akurasi yang didapat.
Hal Praktis yang Perlu Diperhatikan
Beberapa poin implementasi yang layak dipertimbangkan sebelum menerapkan Contextual Retrieval di sistem RAG kamu:
- Ukuran dan boundary chunk tetap memengaruhi performa — eksperimen dengan chunk overlap dan ukuran chunk yang sesuai domain kamu.
- Pilihan embedding model berpengaruh; Anthropic menemukan Gemini dan Voyage embeddings termasuk yang paling diuntungkan dari teknik ini.
- Custom prompt kontekstualisasi untuk domain spesifik (misalnya menyertakan glosarium istilah) bisa memberi hasil lebih baik daripada prompt generik.
- Jumlah chunk yang di-passing ke model — top-20 chunk terbukti lebih efektif dibanding top-10 atau top-5 dalam eksperimen mereka, meski ini tetap perlu diuji ulang untuk use case spesifik.
- Selalu jalankan evaluasi (evals) pada dataset milikmu sendiri, karena performa bisa bervariasi tergantung domain data.
Kesimpulan
Jika sistem RAG kamu sudah berjalan tapi akurasinya masih mengecewakan, kemungkinan besar bukan model embedding-nya yang kurang canggih, melainkan chunk yang kehilangan konteks saat dipisahkan dari dokumen induknya. Contextual Retrieval — kombinasi Contextual Embeddings, Contextual BM25, dan reranking — adalah pendekatan yang terbukti secara eksperimental mampu menekan kegagalan retrieval secara drastis, dengan biaya tambahan yang bisa ditekan signifikan lewat prompt caching. Untuk tim yang serius membangun knowledge base skala besar, ini adalah salah satu teknik dengan ROI tertinggi yang bisa langsung diadopsi.
Referensi
- Anthropic Engineering, 'Introducing Contextual Retrieval', anthropic.com/engineering/contextual-retrieval
- Claude Cookbook, 'Contextual Embeddings Guide', platform.claude.com
- Together AI Docs, 'How to Implement Contextual RAG from Anthropic', docs.together.ai
- DataCamp, 'Contextual Retrieval Anthropic Tutorial', datacamp.com