Kenapa RAG Jadi Topik Hangat di Kalangan Pemilik Bisnis
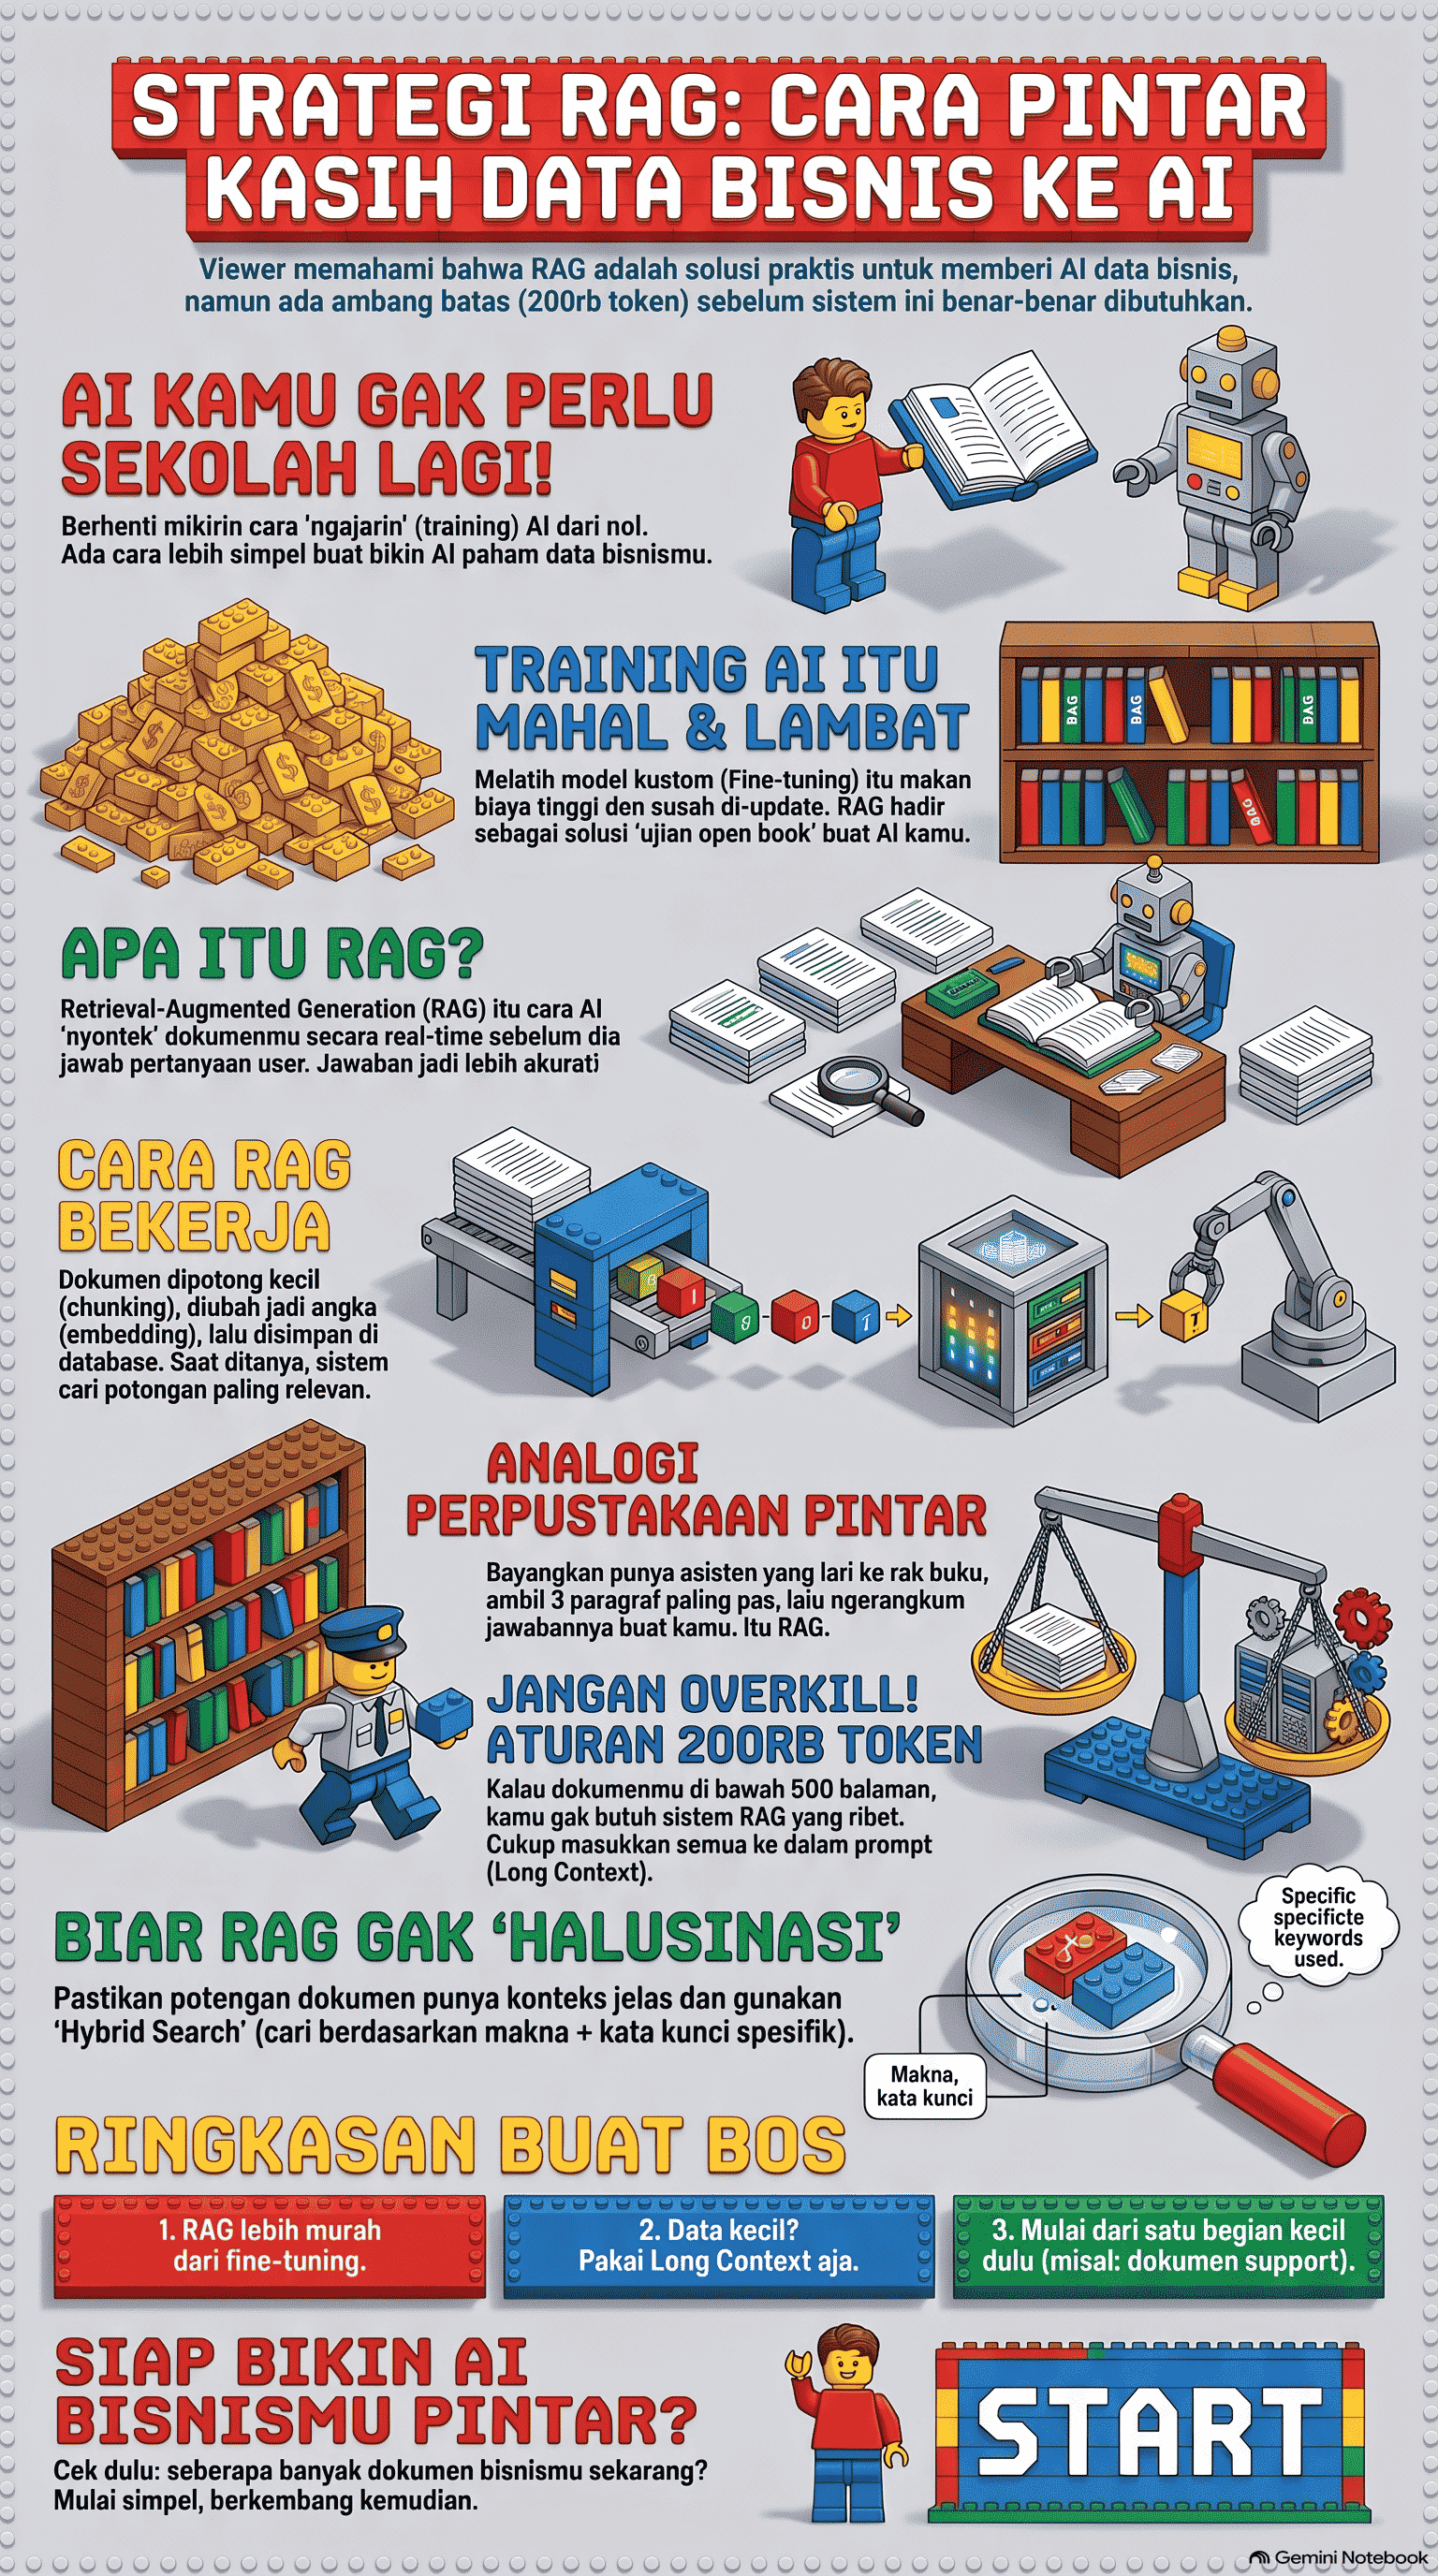
Banyak pemilik bisnis dan founder teknis mendengar bahwa cara terbaik membuat AI "mengerti" bisnis mereka adalah dengan melatih model kustom sendiri. Kenyataannya, untuk sebagian besar kasus penggunaan bisnis, pendekatan ini terlalu mahal, lambat untuk diperbarui, dan sering kali bukan solusi yang tepat. Retrieval-Augmented Generation atau RAG menawarkan cara yang jauh lebih praktis: alih-alih menanamkan pengetahuan ke dalam bobot model lewat fine-tuning, RAG mengambil informasi yang relevan dari dokumen asli milikmu saat pertanyaan diajukan, lalu menyisipkannya ke dalam prompt yang dikirim ke model.
Apa Itu RAG: Dari Dokumen Mentah ke Jawaban yang Akurat
Secara sederhana, RAG bekerja melalui lima tahap. Pertama, dokumen dipecah menjadi potongan-potongan kecil atau "chunk", biasanya berukuran beberapa ratus token. Kedua, setiap chunk diubah menjadi representasi numerik yang disebut embedding menggunakan model embedding khusus, di mana teks dengan makna serupa akan menghasilkan angka yang saling berdekatan secara matematis. Ketiga, embedding ini disimpan dalam vector database yang memungkinkan pencarian berdasarkan kemiripan makna, bukan sekadar kecocokan kata.
Ketika pengguna mengajukan pertanyaan, sistem mengubah pertanyaan itu menjadi embedding juga, lalu mencari chunk-chunk yang paling relevan secara semantik (tahap retrieve). Chunk-chunk ini kemudian disisipkan ke dalam prompt bersama pertanyaan asli, dan model bahasa menghasilkan jawaban berdasarkan konteks nyata tersebut, bukan hanya mengandalkan apa yang sudah dipelajarinya saat training. Salah satu keunggulan pendekatan pencarian semantik ini adalah kemampuannya menemukan dokumen yang relevan meski kata-katanya berbeda jauh dari pertanyaan pengguna, sesuatu yang tidak bisa dilakukan pencarian berbasis kata kunci biasa.
Untuk skala kecil hingga menengah, kamu tidak selalu butuh layanan vector database terpisah. Ekstensi seperti pgvector di PostgreSQL bisa menangani jutaan vektor dengan performa yang cukup baik untuk kebanyakan kasus penggunaan bisnis, sekaligus menghindari kompleksitas sinkronisasi antara dua sistem terpisah.
RAG vs Fine-Tuning vs Long Context: Mana yang Cocok?
Ketiga pendekatan ini sering disalahpahami sebagai hal yang saling menggantikan, padahal masing-masing punya trade-off yang berbeda.
| Aspek | RAG | Fine-Tuning | Long Context |
|---|---|---|---|
| Biaya awal | Sedang (bangun pipeline retrieval) | Tinggi (data training, komputasi) | Rendah (tinggal masukkan dokumen ke prompt) |
| Kesegaran data | Real-time, tinggal update dokumen sumber | Butuh training ulang untuk update | Real-time, tinggal ganti isi prompt |
| Biaya pemeliharaan | Sedang, perlu jaga pipeline chunking & retrieval | Tinggi, perlu retraining berkala | Rendah, tapi biaya per-query naik seiring ukuran konteks |
| Skala data | Cocok untuk knowledge base besar | Cocok untuk mengubah gaya/perilaku model | Cocok untuk knowledge base kecil-menengah |
Fine-tuning cocok ketika kamu ingin mengubah cara model merespons atau menanamkan kemampuan baru, bukan sekadar menambah fakta. Sementara itu, long context (memasukkan seluruh dokumen langsung ke prompt) menjadi jauh lebih murah dan cepat berkat fitur prompt caching, yang bisa memangkas biaya hingga signifikan untuk dokumen yang sering dipakai berulang.
Aturan 200 Ribu Token: Kapan Kamu Tidak Butuh RAG Sama Sekali
Ini bagian yang sering diabaikan: jika seluruh knowledge base bisnismu berukuran di bawah 200.000 token atau sekitar 500 halaman, kamu bisa langsung memasukkan semuanya ke dalam prompt tanpa perlu membangun sistem RAG sama sekali. Dengan prompt caching, pendekatan ini menjadi jauh lebih cepat dan hemat biaya karena dokumen yang sama tidak perlu diproses ulang dari nol setiap kali ada pertanyaan baru. Baru ketika knowledge base bisnismu tumbuh melewati batas ini, membangun sistem RAG menjadi solusi yang lebih masuk akal secara skala.
Banyak bisnis kecil hingga menengah, terutama yang baru mulai eksplorasi AI, sebenarnya berada di bawah ambang batas ini. Membangun infrastruktur RAG yang kompleks untuk kebutuhan yang sebenarnya bisa diselesaikan dengan long context adalah pemborosan sumber daya.
Di Mana RAG Sering Gagal
RAG terdengar sederhana di atas kertas, tapi implementasinya penuh jebakan. Tiga masalah paling umum:
Chunking yang buruk. Ketika dokumen dipotong sembarangan, sebuah chunk bisa kehilangan konteks pentingnya. Misalnya, potongan teks berbunyi "pendapatan perusahaan tumbuh 3% dari kuartal sebelumnya" tidak berguna jika sistem tidak tahu perusahaan mana dan kuartal kapan yang dimaksud. Solusinya adalah menambahkan konteks penjelas ke setiap chunk sebelum di-embed, sebuah teknik yang terbukti mengurangi kegagalan retrieval secara signifikan.
Keyword miss. Model embedding unggul menangkap makna semantik, tapi bisa gagal menemukan kecocokan kata kunci yang sangat spesifik, seperti kode error atau nomor produk tertentu. Menggabungkan pencarian semantik dengan BM25, teknik pencarian berbasis kata kunci klasik, membantu menutup celah ini.
Konteks yang hilang saat retrieval. Bahkan dengan chunking dan pencarian yang baik, sistem tetap bisa gagal jika jumlah chunk yang diambil terlalu sedikit atau urutan relevansinya kurang tepat. Menambahkan tahap reranking, di mana kandidat hasil pencarian awal disaring ulang oleh model khusus sebelum dikirim ke LLM, terbukti mampu menaikkan akurasi lebih jauh, meski dengan tambahan biaya dan latensi.
Ruang Lingkup Realistis untuk Proyek RAG Pertama
Jangan mulai dari knowledge base raksasa yang mencakup seluruh perusahaan. Pilih satu domain yang jelas batasnya dan nilai bisnisnya terukur, misalnya dokumentasi internal untuk tim support, katalog produk untuk chatbot penjualan, atau riwayat tiket dukungan pelanggan untuk mempercepat respons agen. Ketiga domain ini punya volume data yang cukup untuk dianggap berharga, tapi cukup terbatas agar kamu bisa mengevaluasi kualitas retrieval-nya dengan jelas sebelum memperluas cakupan.
Penutup
RAG bukan solusi ajaib, tapi untuk kebanyakan bisnis yang ingin AI menjawab berdasarkan data internal mereka, RAG jauh lebih praktis dan terjangkau dibandingkan melatih model kustom dari nol. Yang penting adalah memahami dulu skala data yang kamu punya: kalau masih kecil, long context dengan prompt caching mungkin sudah cukup. Kalau sudah besar, barulah investasi ke pipeline RAG yang matang, lengkap dengan chunking yang baik, hybrid search, dan reranking, benar-benar sepadan dengan hasilnya.
Referensi
- Anthropic Engineering, "Introducing Contextual Retrieval"
- Encore, "You Probably Don't Need a Vector Database"
- Claude Cookbook, "Enhancing RAG with Contextual Retrieval"