Pendahuluan
Setiap tim yang mulai membangun produk berbasis LLM hampir pasti sampai di pertanyaan yang sama: pengetahuan tambahan ini sebaiknya disimpan di mana? Apakah cukup dimasukkan ke memory, perlu dibangun sistem RAG, atau model harus di-fine-tune? Ketiganya sering dianggap bisa saling menggantikan, padahal masing-masing menyelesaikan masalah yang berbeda.
Cara berpikir yang paling membantu datang dari konsep context engineering yang dijelaskan tim Anthropic. Model bahasa punya attention budget yang terbatas: semakin banyak token yang dimasukkan ke context window, kemampuan model untuk mengingat informasi di dalamnya justru menurun, fenomena yang disebut context rot. Jadi tantangannya bukan sekadar menambah pengetahuan, tetapi memasukkan token yang paling relevan, pada saat yang tepat, dengan biaya sekecil mungkin. Memory, RAG, dan fine-tuning adalah tiga jawaban berbeda untuk tantangan itu.
1. Memory: Fakta dan Preferensi yang Berumur Panjang
Memory adalah catatan kecil yang dikurasi dan dibawa lintas sesi. Isinya bukan dokumen, melainkan fakta ringkas yang hampir selalu relevan: preferensi pengguna, konvensi proyek, konfigurasi lingkungan, atau pelajaran dari kesalahan sebelumnya.
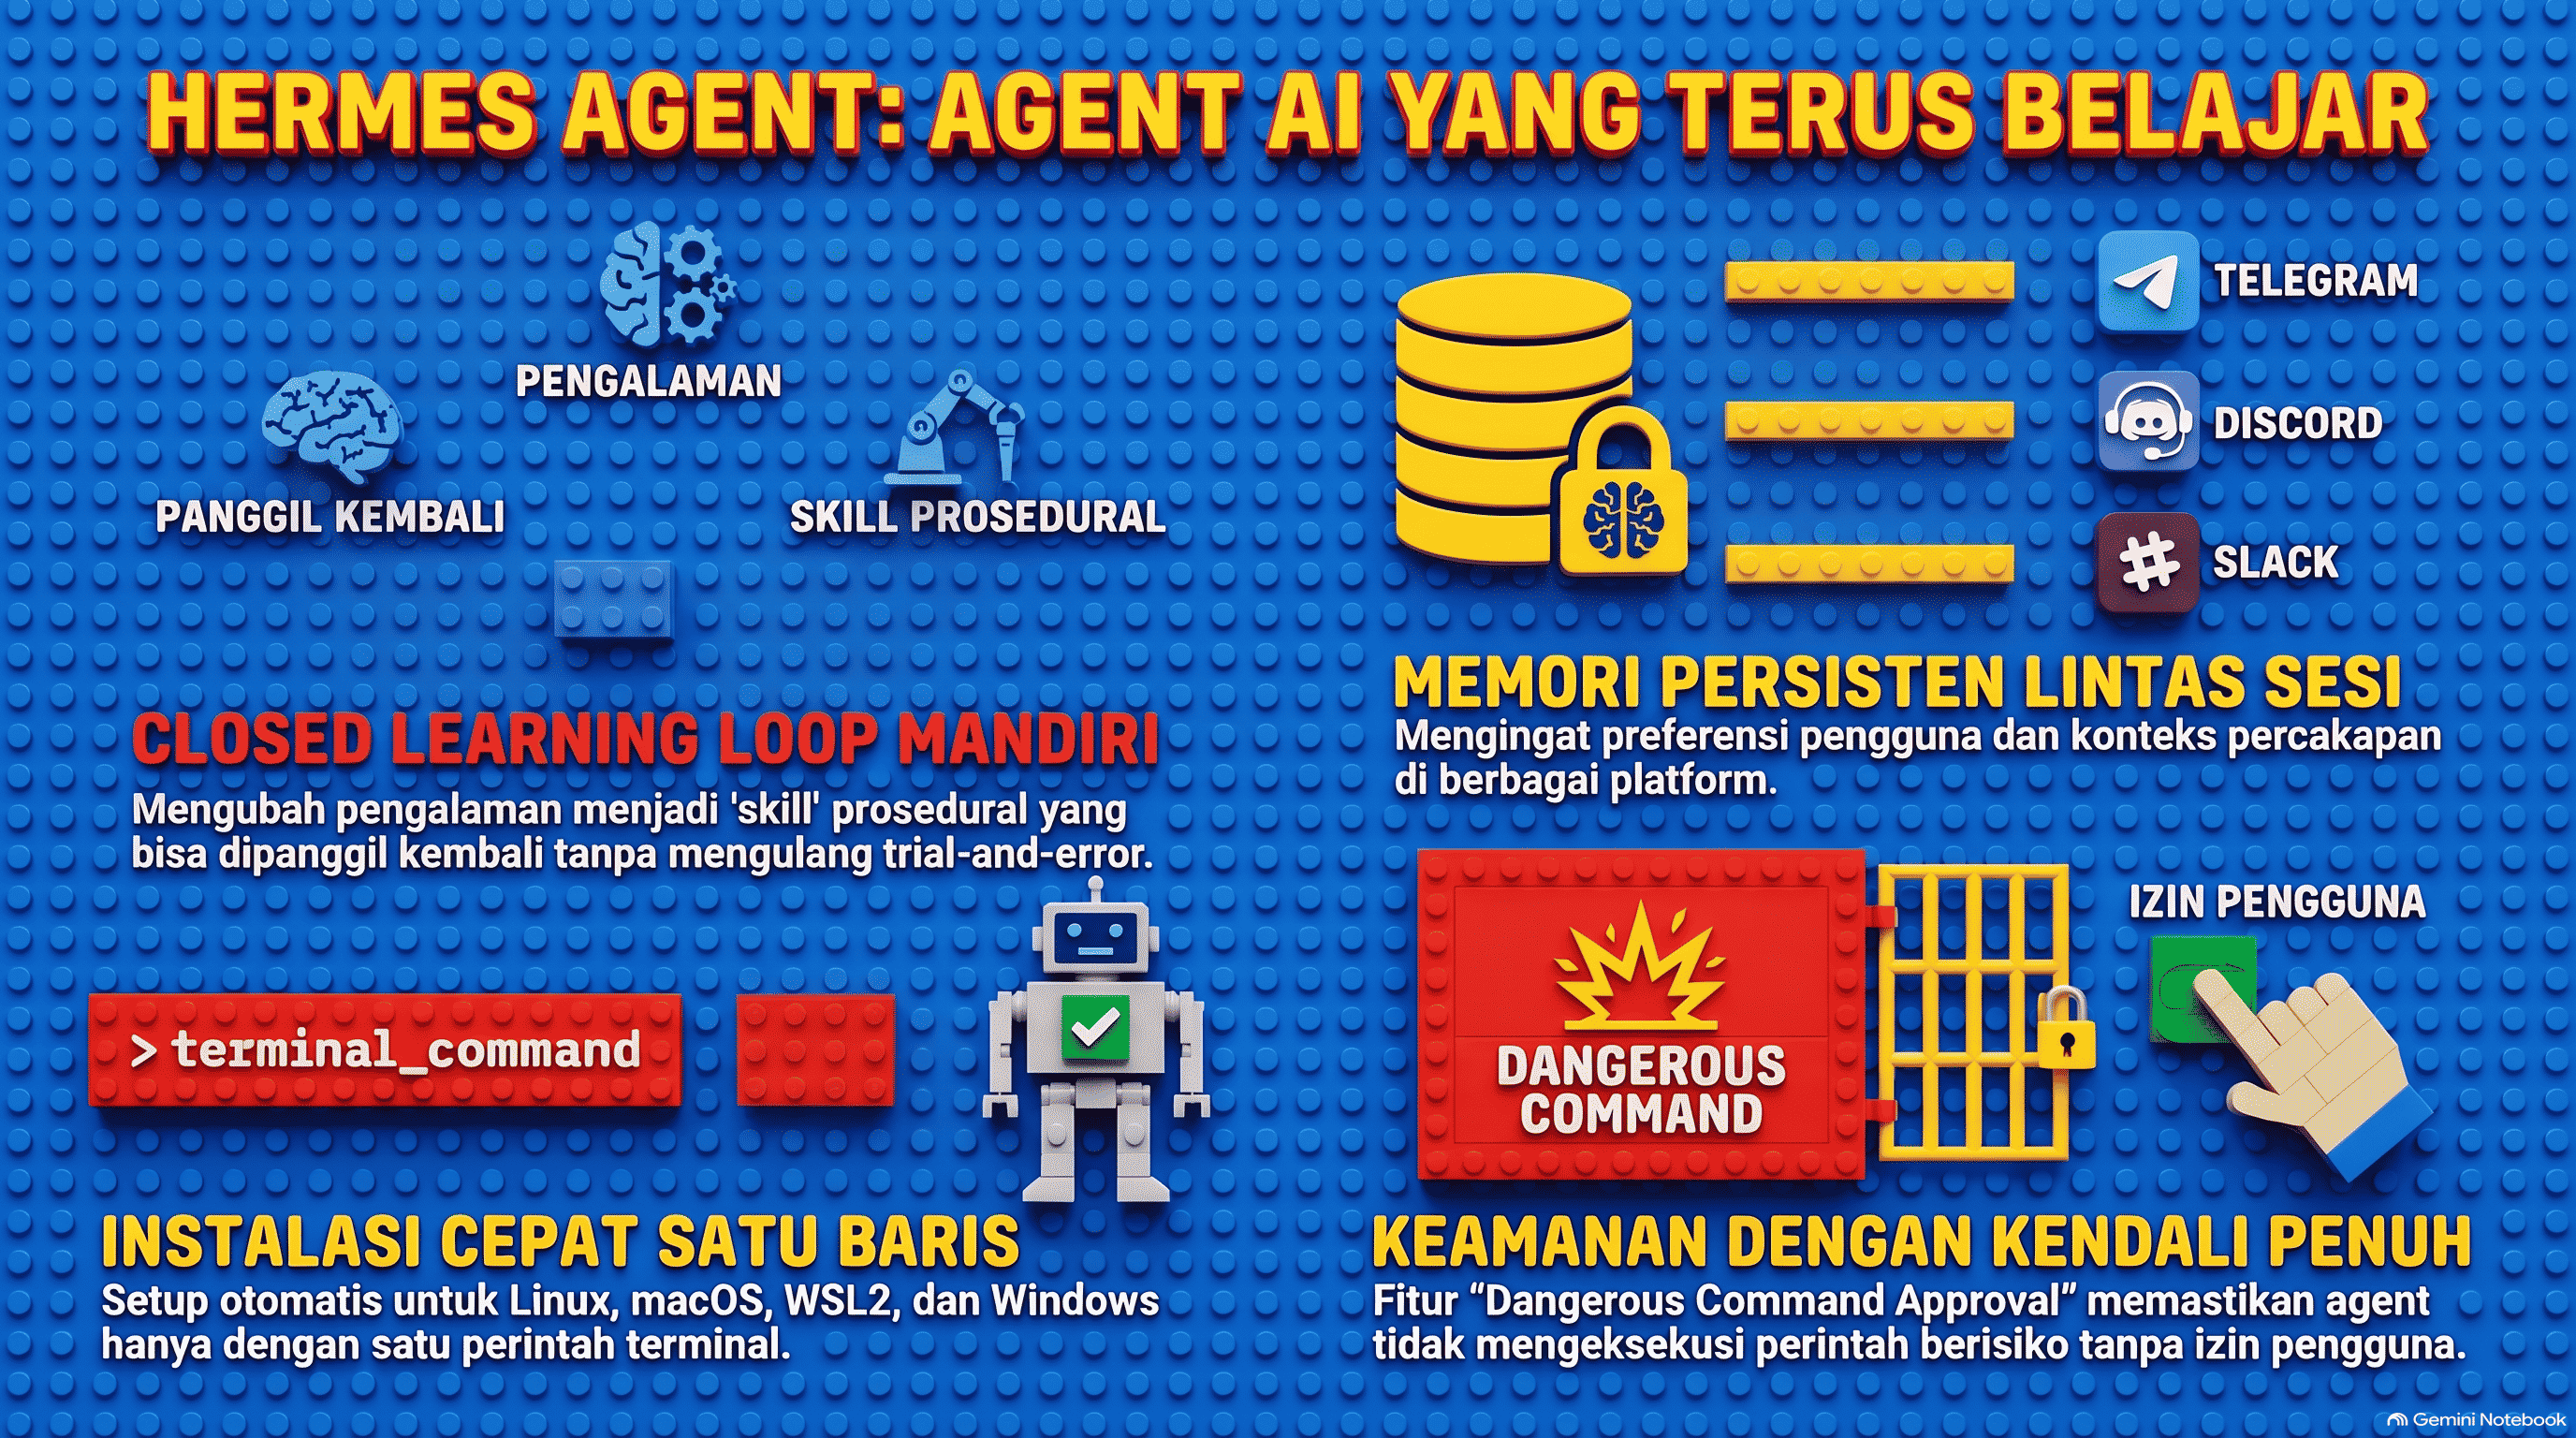
Contoh implementasi yang konkret bisa dilihat di Hermes Agent dari Nous Research. Memory-nya hanya terdiri dari dua file: MEMORY.md untuk catatan agent (dibatasi sekitar 2.200 karakter atau kurang lebih 800 token) dan USER.md untuk profil pengguna (sekitar 1.375 karakter atau kurang lebih 500 token). Keduanya disuntikkan ke system prompt sebagai snapshot beku di awal sesi agar prefix cache tetap terjaga. Agent mengelolanya sendiri lewat tool dengan aksi add, replace, dan remove.
Batasan ukuran ini disengaja. Dokumentasi Hermes menyarankan untuk tidak menyimpan fakta yang mudah dicari ulang, dump data mentah seperti log atau tabel, maupun informasi sementara yang hanya berlaku di satu sesi. Untuk riwayat percakapan yang panjang, Hermes memakai mekanisme terpisah, yaitu session_search berbasis SQLite FTS5 yang hanya dipanggil saat dibutuhkan. Karena isi memory masuk ke system prompt, entri baru juga dipindai terhadap pola prompt injection sebelum diterima.
Anthropic menyebut pola serupa sebagai structured note-taking atau agentic memory: agent menulis catatan di luar context window, misalnya file NOTES.md, lalu membacanya kembali di waktu berikutnya. Claude Developer Platform juga menyediakan memory tool berbasis file untuk menjaga status proyek lintas sesi.
Gunakan memory ketika: informasinya kecil, stabil, berkaitan dengan pengguna atau proyek tertentu, dan perlu hadir di hampir setiap interaksi.
2. RAG: Basis Pengetahuan yang Besar dan Sering Berubah
Retrieval-Augmented Generation (RAG) mengambil potongan informasi yang relevan dari basis pengetahuan lalu menambahkannya ke prompt. Alurnya standar: dokumen dipecah menjadi chunk berukuran beberapa ratus token, diubah menjadi embedding, disimpan di vector database, lalu dicari berdasarkan kemiripan semantik saat ada query.
Beberapa pelajaran penting dari riset Contextual Retrieval Anthropic:
- Cek dulu apakah RAG benar-benar diperlukan. Jika basis pengetahuan di bawah 200.000 token (sekitar 500 halaman), seluruhnya bisa dimasukkan langsung ke prompt. Dengan prompt caching, latensi bisa turun lebih dari 2x dan biaya hingga 90%.
- Gabungkan embedding dengan BM25. Embedding kuat untuk memahami makna, tetapi bisa meleset untuk kecocokan eksak seperti kode error
TS-999. BM25 menangani pencarian leksikal semacam ini. - Tambahkan konteks ke setiap chunk. Chunk seperti 'pendapatan naik 3% dari kuartal sebelumnya' tidak berguna tanpa tahu perusahaan dan periodenya. Contextual Retrieval menambahkan penjelas singkat sekitar 50 sampai 100 token ke tiap chunk sebelum di-index, dan menurunkan kegagalan retrieval sebesar 49%. Dengan tambahan reranking, penurunannya mencapai 67%.
Kekuatan utama RAG adalah kesegaran data. Saat harga, dokumentasi, atau kebijakan berubah, Anda cukup memperbarui index tanpa menyentuh model. Jawaban juga bisa ditelusuri kembali ke dokumen sumbernya, sesuatu yang sangat penting untuk kebutuhan audit dan kepercayaan pengguna.
Gunakan RAG ketika: volume data besar, sering diperbarui, dan jawaban harus akurat serta bisa diverifikasi.
3. Fine-Tuning: Mengubah Gaya dan Perilaku, Bukan Menambah Fakta
Fine-tuning melatih ulang bobot model dengan contoh-contoh baru. Dampaknya paling terasa pada cara model merespons: format output yang konsisten, gaya bahasa brand, cara mengklasifikasi, atau pola penalaran untuk tugas yang sempit dan berulang.
Kesalahan yang paling sering terjadi adalah memakai fine-tuning untuk memasukkan pengetahuan faktual, misalnya daftar harga paket hosting atau isi dokumentasi produk. Pendekatan ini bermasalah karena fakta yang tertanam di bobot model tidak bisa diperbarui tanpa melatih ulang, model tidak bisa menunjukkan dari mana jawabannya berasal, dan model tetap bisa mengarang detail yang terdengar meyakinkan. Untuk fakta, RAG hampir selalu lebih murah, lebih cepat diperbarui, dan lebih aman.
Sebelum memutuskan fine-tuning, pastikan cara yang lebih ringan sudah dicoba. Anthropic merekomendasikan memulai dari prompt minimal dengan model terbaik yang tersedia, lalu menambahkan instruksi yang jelas dan sekumpulan contoh yang beragam dan kanonik berdasarkan kegagalan yang ditemukan saat pengujian. Hermes Agent juga menunjukkan bahwa kepribadian dan gaya bicara default bisa diatur lewat file SOUL.md tanpa melatih ulang model sama sekali.
Gunakan fine-tuning ketika: prompt dan contoh sudah tidak cukup, Anda butuh konsistensi perilaku dalam skala besar, atau ingin memindahkan kemampuan tertentu ke model yang lebih kecil agar lebih murah dan cepat.
4. Tabel Keputusan
| Kebutuhan | Frekuensi Perubahan Data | Volume | Kebutuhan Akurasi | Pendekatan |
|---|---|---|---|---|
| Preferensi user, konvensi proyek | Jarang, bertambah perlahan | Sangat kecil (ratusan token) | Konsisten di setiap sesi | Memory |
| Dokumen referensi kecil | Sedang | Di bawah ~200 ribu token | Tinggi | Full context + prompt caching |
| Dokumentasi, FAQ, kebijakan, katalog | Sering (harian/mingguan) | Besar dan terus bertambah | Tinggi, perlu sumber | RAG (embedding + BM25 + reranking) |
| Kode error, SKU, nomor invoice | Sering | Besar | Harus cocok persis | RAG dengan BM25 / contextual BM25 |
| Riwayat percakapan lama | Terus bertambah | Tidak terbatas | Recall detail spesifik | Session search / retrieval atas histori |
| Gaya bahasa, format output, tone | Hampir tidak pernah | Ratusan hingga ribuan contoh | Konsistensi perilaku | Prompt + few-shot, lalu fine-tuning |
Aturan praktisnya sederhana: semakin sering data berubah, semakin jauh data itu harus diletakkan dari bobot model. Data yang berubah harian cocok di RAG, data personal yang stabil cocok di memory, dan hanya perilaku yang hampir tidak pernah berubah yang layak ditanam lewat fine-tuning.
5. Kombinasi yang Paling Umum di Produksi
Di produksi, ketiganya jarang dipilih salah satu saja. Kombinasi yang paling sering ditemui adalah system prompt yang solid + RAG + memory, dengan fine-tuning sebagai opsi terakhir. Berikut urutan implementasi yang kami sarankan:
- Baseline prompt dan evals. Tulis system prompt yang jelas, siapkan beberapa contoh, dan buat set pertanyaan uji. Tanpa evals, Anda tidak akan tahu apakah langkah berikutnya benar-benar memperbaiki hasil.
- Full context + prompt caching jika basis pengetahuan masih kecil. Ini sejalan dengan saran Anthropic untuk melakukan hal paling sederhana yang berhasil.
- RAG saat data sudah terlalu besar atau sering berubah. Mulai dari hybrid embedding + BM25, lalu tambahkan contextual retrieval dan reranking jika akurasi belum memadai.
- Memory untuk personalisasi dan kesinambungan lintas sesi, dengan batas ukuran yang ketat dan kontrol atas apa saja yang boleh disimpan.
- Fine-tuning hanya jika evals menunjukkan masalah perilaku atau format yang tidak bisa diselesaikan lewat prompt.
Sebagai contoh, chatbot support untuk layanan hosting bisa memakai RAG untuk dokumentasi, tutorial, dan harga paket; memory untuk mengingat bahwa pelanggan tertentu memakai Laravel dengan versi PHP tertentu; serta system prompt untuk menjaga nada bahasa. Fine-tuning baru masuk jika, misalnya, Anda ingin memindahkan klasifikasi tiket ke model kecil yang lebih hemat biaya.
Penutup
Memory, RAG, dan fine-tuning bukan pesaing, melainkan alat untuk lapisan yang berbeda. Memory menjawab siapa penggunanya dan apa konteks kerjanya, RAG menjawab apa faktanya saat ini, dan fine-tuning menjawab bagaimana model seharusnya berperilaku. Mulailah dari yang paling sederhana, ukur dengan evals, dan tambahkan kompleksitas hanya ketika data membuktikan bahwa Anda memang membutuhkannya.
Butuh bantuan membangun website atau aplikasi yang siap diintegrasikan dengan chatbot berbasis RAG? Tim katili.dev siap membantu, mulai dari infrastruktur hosting hingga implementasi.