Kenapa Anggaran AI Agent Sering Meleset
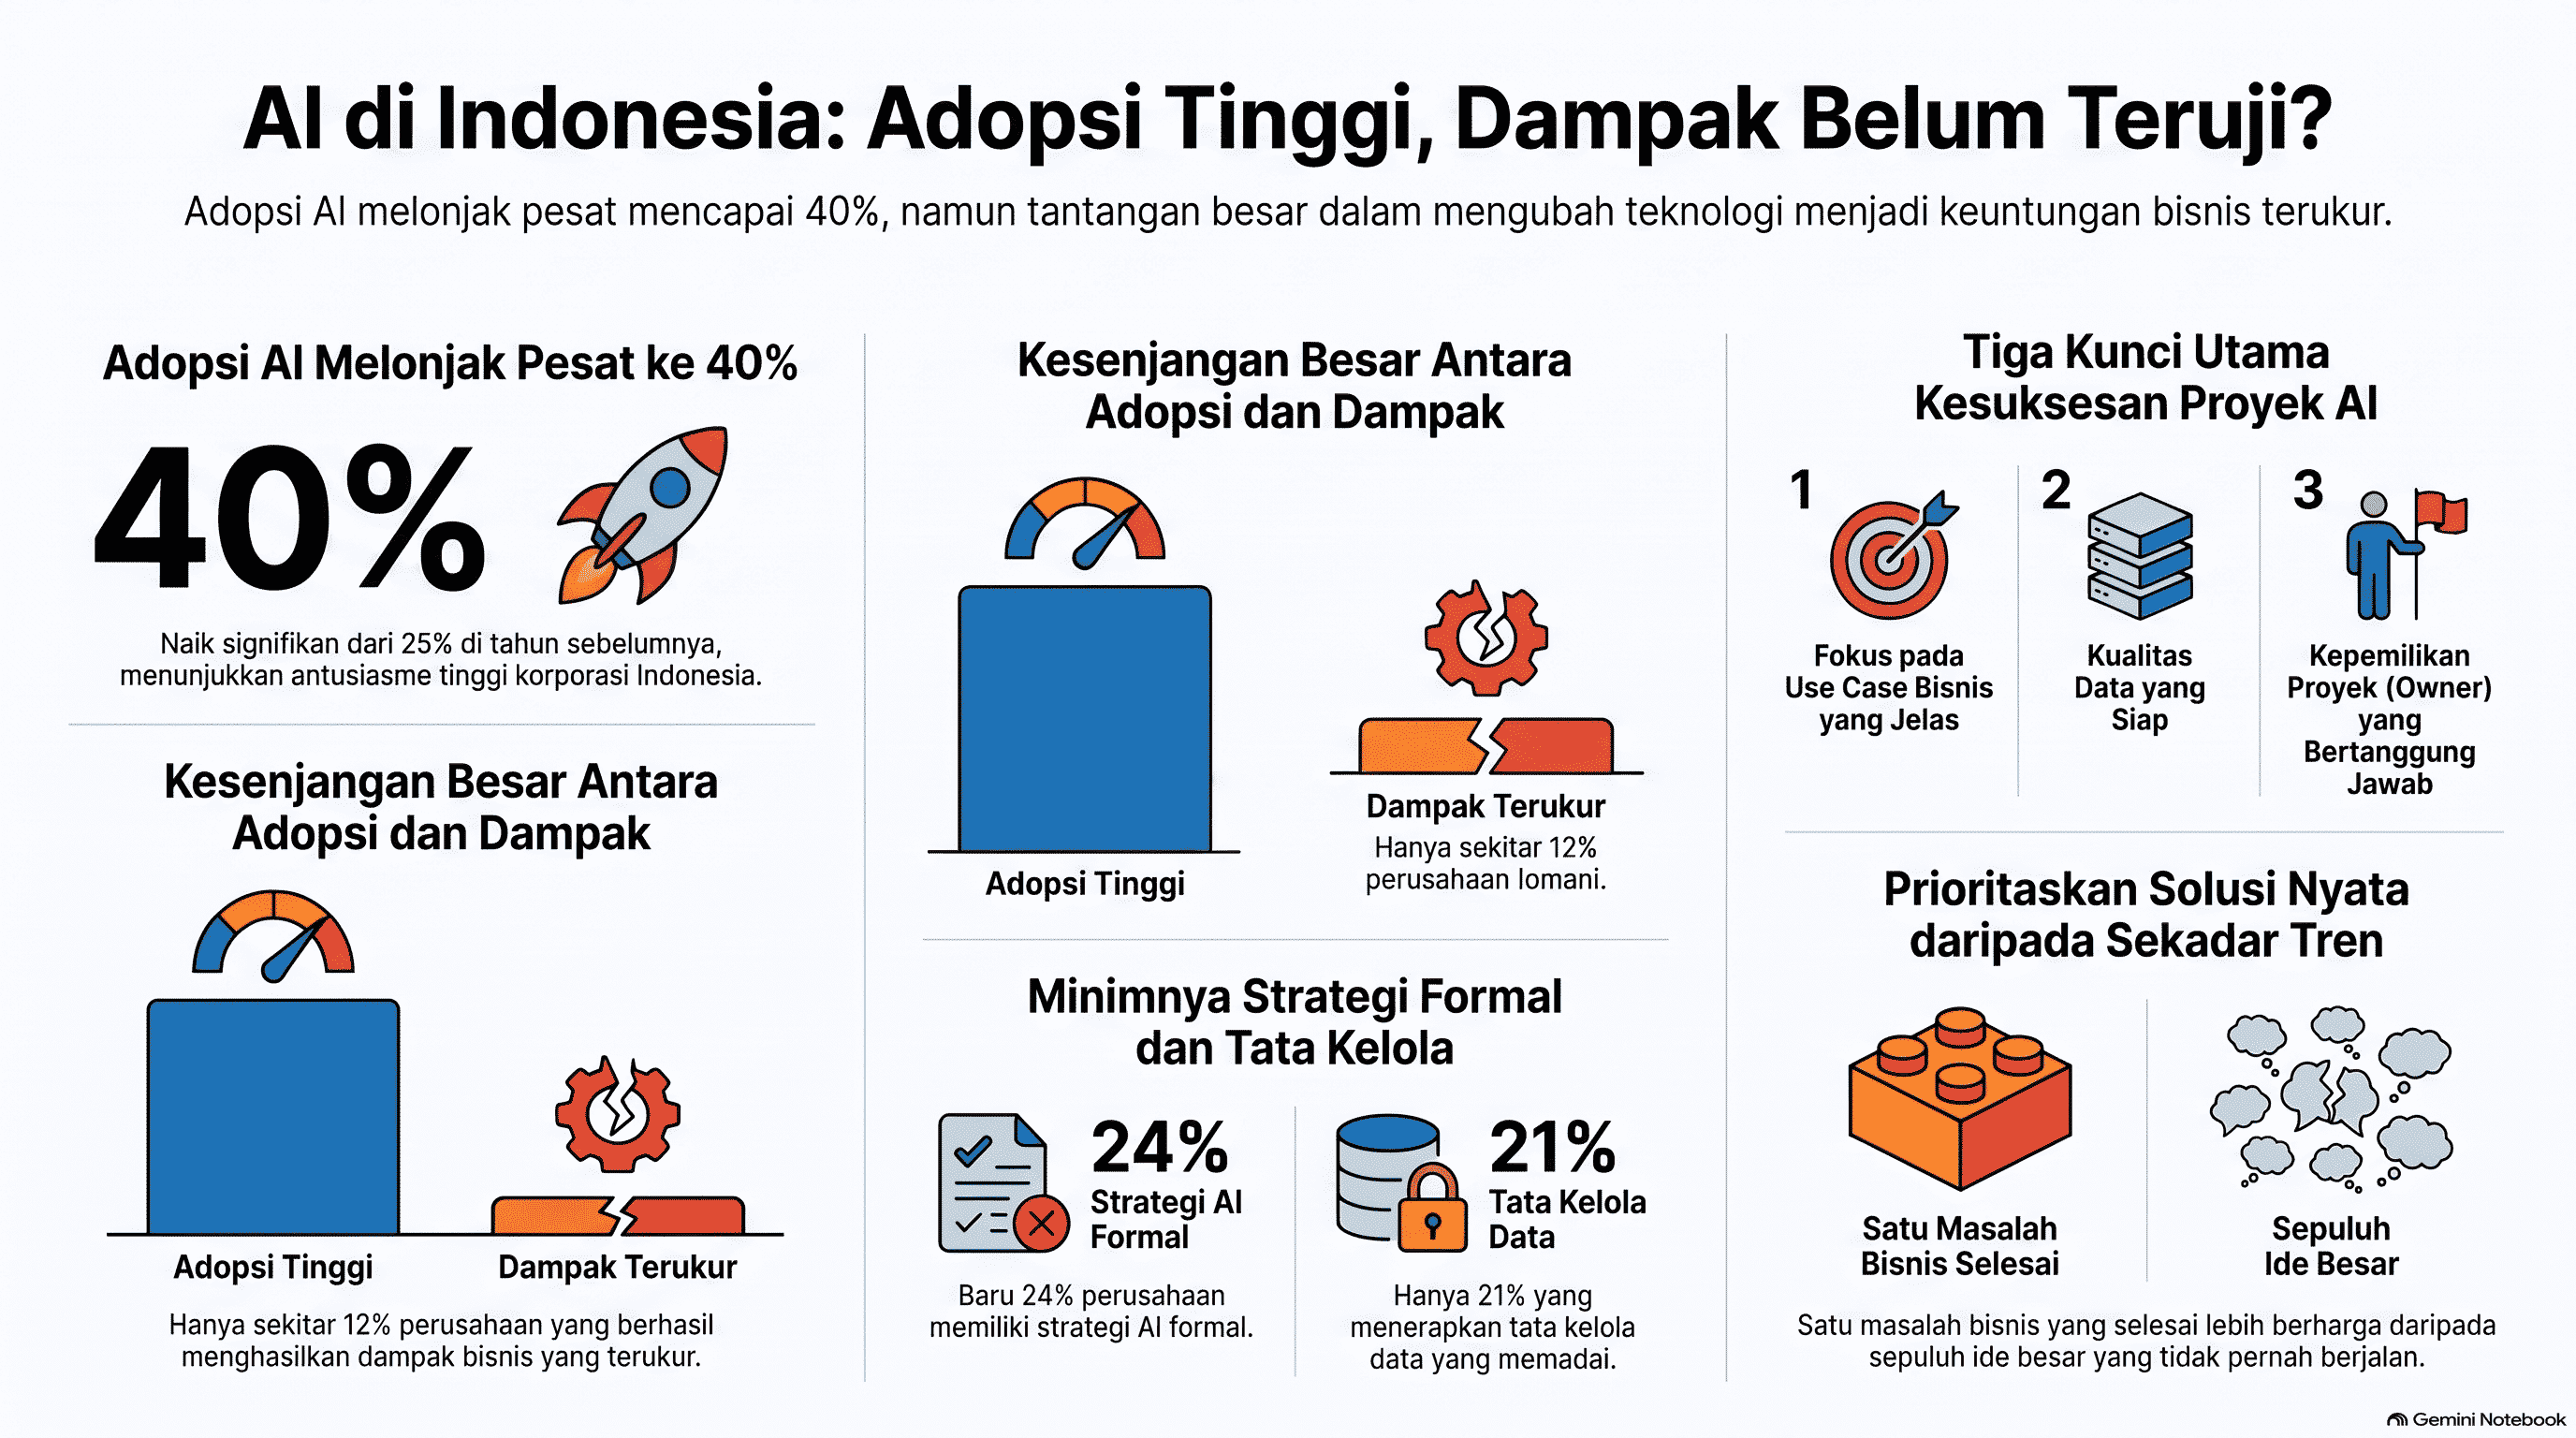
Adopsi AI di Indonesia bergerak cepat. Studi AWS yang dipaparkan di AWS Summit Jakarta 2026 mencatat 40 persen perusahaan di Indonesia sudah memakai AI dalam operasional, naik dari 25 persen pada tahun sebelumnya. Namun, 56 persen dari perusahaan tersebut masih berada di tahap awal eksplorasi, dan salah satu tantangan yang disorot adalah pengukuran manfaat investasi alias ROI.
Masalahnya sering kali sederhana: anggaran disusun dari harga langganan atau harga per token di halaman pricing, padahal AI agent adalah sistem yang berjalan berulang-ulang dan terus membaca konteks. Biaya sebenarnya baru terasa setelah agent hidup beberapa minggu. Artikel ini membongkar pos-pos biaya tersebut satu per satu agar anggaran proyek AI Anda lebih realistis.
Pos Biaya Utama AI Agent
Secara garis besar, ada empat pos biaya yang wajib masuk Rencana Anggaran Biaya (RAB).
| Pos Biaya | Apa yang Dibayar | Sifat Biaya |
|---|---|---|
| Token input/output | Semua teks yang dikirim ke model (instruksi, riwayat, hasil tool) dan teks yang dihasilkan model | Variabel, naik seiring pemakaian |
| Server | VPS/cloud untuk menjalankan gateway agent, atau GPU jika memakai model lokal | Tetap per bulan |
| Storage embedding & memori | Vector database atau file memori, log, dan skill | Tumbuh perlahan seiring data |
| Monitoring | Log, alerting, dashboard pemakaian token, audit keamanan | Tetap + waktu tim |
Token adalah pos yang paling sulit ditebak. Token input biasanya jauh lebih banyak daripada output, karena di setiap putaran agent mengirim ulang instruksi sistem, definisi tool, riwayat percakapan, dan hasil tool.
Server relatif mudah diprediksi. Sebagai gambaran, dokumentasi OpenClaw, salah satu agent open-source populer, menyebut kebutuhan minimum RAM 2 GB untuk gateway saja dengan rekomendasi 4 GB ke atas, serta disk minimum 500 MB dan idealnya 2 GB ke atas untuk memori, skill, dan log. Jika ingin menghindari biaya API dengan model lokal, kebutuhannya melonjak ke GPU: sekitar 16 GB VRAM untuk model kelas 14B yang cukup untuk sebagian besar tugas, hingga 40–80 GB (kelas A100) untuk kualitas yang mendekati model cloud.
Storage embedding sering dianggap kecil, padahal setiap dokumen yang diindeks perlu di-embed ulang ketika isinya berubah. Hal ini akan dibahas lebih lanjut di bagian maintenance.
Monitoring bukan pilihan tambahan. Agent yang punya akses ke file, shell, dan aplikasi bisnis wajib diawasi, baik dari sisi biaya maupun keamanan.
Pendorong Biaya Terbesar yang Sering Terlewat: Heartbeat
Banyak pemilik bisnis menghitung biaya berdasarkan jumlah permintaan dari user. Padahal agent otonom bisa menghabiskan token tanpa ada satu pun user yang bertanya.
OpenClaw memiliki fitur heartbeat yang aktif setiap 30 menit, 24 jam sehari, untuk mengecek tugas yang tertunda, dan setiap siklusnya memakan token. Dokumentasinya sendiri menyebut heartbeat sebagai pendorong biaya terbesar. Berikut estimasi biaya yang mereka cantumkan:
| Tingkat Pemakaian | Perkiraan Harian | Bulanan |
|---|---|---|
| Ringan (chat CLI saja) | $1–5 | $30–150 |
| Menengah (heartbeat + channel) | $5–20 | $150–600 |
| Berat (banyak channel, skill kompleks) | $20–50+ | $600–1.500+ |
| Model lokal (Ollama/vLLM) | $0 biaya API | $0 biaya API |
Hitungan sederhananya: sekali setiap 30 menit berarti 48 siklus per hari, atau sekitar 1.440 siklus per bulan. Jika setiap siklus membawa konteks 100 ribu token, totalnya 144 juta token input per bulan hanya untuk memeriksa apakah ada pekerjaan. Dengan mode sesi terisolasi yang memangkas konteks menjadi 2–5 ribu token per siklus, angkanya turun menjadi sekitar 3–7 juta token.
Langkah penghematan yang disarankan dokumentasi OpenClaw:
- Gunakan model murah (kelas Haiku) untuk heartbeat, hemat 80–90% biaya heartbeat.
- Perpanjang interval menjadi 60 menit, hemat 50%.
- Aktifkan jam tenang saat tidak ada aktivitas, hemat 33%.
- Gunakan model lokal untuk heartbeat, biaya API heartbeat menjadi nol.
- Aktifkan
isolatedSession, konteks turun dari 100K menjadi 2–5K token per siklus.
Satu kasus yang terdokumentasi menunjukkan tagihan $1.200 per bulan turun menjadi $36 hanya dengan pengaturan routing model. Pelajarannya untuk RAB: tanyakan kepada vendor atau tim Anda, berapa kali agent berjalan ketika tidak ada yang memakainya?
Context Window yang Boros = Tagihan yang Boros
Setiap token di dalam context window dibayar, di setiap putaran. Tim Applied AI Anthropic dalam tulisannya tentang context engineering menjelaskan bahwa konteks adalah sumber daya terbatas dengan manfaat yang makin menurun. Semakin banyak token, semakin turun kemampuan model mengingat informasi secara akurat, fenomena yang dikenal sebagai context rot. Artinya, konteks yang gemuk tidak hanya mahal, tetapi juga bisa menurunkan kualitas jawaban.
Prinsip yang mereka tawarkan adalah mencari kumpulan token terkecil yang paling bernilai untuk menghasilkan keluaran yang diinginkan. Dalam praktik, ini berarti:
- Instruksi sistem yang ringkas tapi jelas. Hindari menumpuk daftar panjang kasus pinggiran; lebih baik gunakan beberapa contoh kanonik yang beragam.
- Tool yang ramping. Kumpulan tool yang gemuk dengan fungsi tumpang tindih disebut sebagai salah satu kegagalan paling umum. Setiap definisi tool ikut masuk ke konteks.
- Retrieval just-in-time. Alih-alih memuat semua dokumen di awal, agent menyimpan referensi ringan (path file, query tersimpan, link) dan memuat data hanya saat dibutuhkan.
- Compaction dan pembersihan hasil tool. Riwayat panjang diringkas, dan hasil tool lama yang tidak lagi diperlukan dibuang dari konteks.
- Catatan terstruktur. Agent menulis progres ke file di luar konteks, lalu membacanya kembali saat diperlukan.
- Sub-agent. Sub-agent boleh menjelajah dengan puluhan ribu token, tetapi hanya mengembalikan ringkasan sekitar 1.000–2.000 token ke agent utama.
Biaya Maintenance yang Jarang Masuk RAB
AI agent bukan proyek sekali jadi. Ada biaya berulang yang perlu dianggarkan dalam bentuk jam kerja tim:
- Re-index embedding. Setiap kali dokumen, katalog produk, atau SOP berubah, data harus di-embed ulang. Ada biaya komputasi embedding, sekaligus risiko indeks basi yang membuat agent menjawab dengan informasi lama.
- Update dependency dan keamanan. Contoh nyata dari OpenClaw: tercatat 10 CVE dalam 6 bulan, termasuk celah RCE kritis, serta 341 skill berbahaya yang ditemukan di marketplace komunitasnya. Dokumentasinya menyarankan untuk selalu memakai versi terbaru. Artinya, ada waktu rutin untuk patching, pengujian, dan audit.
- Penyesuaian prompt dan skill. Model baru dirilis, perilaku bergeser, dan proses bisnis berubah. Menurut Anthropic, prompt yang terlalu kaku dengan logika if-else yang di-hardcode justru menambah kerumitan maintenance seiring waktu.
- Review hasil kerja agent. Seseorang tetap harus memeriksa keluaran agent, terutama di tahap awal.
Aturan praktisnya: sisihkan jam kerja engineer per bulan secara eksplisit di anggaran, jangan diasumsikan nol.
Cara Menghitung ROI yang Jujur
Kesalahan umum adalah membandingkan tagihan API dengan gaji satu karyawan. Perbandingan yang jujur adalah total biaya kepemilikan melawan jam kerja yang benar-benar tergantikan.
Biaya total bulanan = token + server + storage + monitoring + (jam maintenance × tarif per jam) + (biaya setup ÷ masa pakai dalam bulan).
Nilai yang dihasilkan = (jam tugas yang benar-benar diambil alih agent − jam review manusia − jam koreksi kesalahan) × tarif per jam karyawan.
Contoh ilustrasi dengan angka hipotetis:
| Komponen | Per Bulan |
|---|---|
| Token API | Rp3.000.000 |
| Server + storage + monitoring | Rp1.000.000 |
| Maintenance 8 jam × Rp150.000 | Rp1.200.000 |
| Amortisasi setup (Rp24 juta ÷ 12 bulan) | Rp2.000.000 |
| Total biaya | Rp7.200.000 |
| Jam tergantikan: 80 jam − 20 jam review | 60 jam |
| Nilai (60 jam × Rp100.000) | Rp6.000.000 |
Di atas kertas agent mengerjakan 80 jam kerja, tetapi setelah dikurangi waktu review, nilainya belum menutup biaya. Solusinya bukan langsung membatalkan proyek, melainkan menekan biaya heartbeat, merapikan konteks, atau memperluas cakupan tugas hingga angkanya positif. Ukur minimal selama 2–3 bulan, karena bulan pertama biasanya penuh biaya setup dan penyetelan.
Penutup
Biaya nyata AI agent jarang datang dari satu tagihan besar, melainkan dari hal-hal kecil yang berulang: heartbeat setiap 30 menit, konteks yang terus menggemuk, dan maintenance yang tidak dianggarkan. Dengan memetakan empat pos biaya utama, mengendalikan agent yang berjalan terus-menerus, menerapkan context engineering, dan menghitung ROI berdasarkan jam kerja yang benar-benar tergantikan, Anda bisa menyusun anggaran proyek AI yang tidak meleset.
Membutuhkan server yang stabil untuk menjalankan AI agent atau website bisnis Anda? Tim katili.dev siap membantu, mulai dari hosting hingga pengembangan.