Kenapa Agent Gagal Padahal Modelnya Pintar
Banyak tim memulai proyek AI agent dengan pertanyaan yang keliru: model mana yang paling pintar? Setelah model terbaik dipasang, agent tetap berhenti di tengah tugas, mengaku selesai padahal pekerjaan belum tuntas, atau memanggil tool dengan parameter ngawur. Masalahnya bukan pada kemampuan bernalar model, melainkan pada lapisan perangkat lunak di sekitarnya yang menerjemahkan penalaran itu menjadi aksi nyata. Lapisan itu disebut harness.
Dalam pengalaman lapangan, sebagian besar kegagalan agent di produksi berasal dari harness, bukan dari model. Karena itu, sejak awal 2026 istilah harness engineering mulai dipakai sebagai disiplin tersendiri, sejajar dengan prompt engineering dan context engineering.
Definisi: Harness Adalah Infrastruktur di Sekitar Model
Agent harness (sering juga disebut agent scaffolding) adalah infrastruktur perangkat lunak yang membungkus sebuah large language model sehingga model itu bisa beroperasi sebagai agent. Harness mengurus pemanggilan tool, memory, persistensi state, lingkungan eksekusi, dan feedback loop — semua hal di luar penalaran internal model.
Kenapa ini penting? Karena sebuah LLM pada dasarnya stateless, tidak punya tangan, dan hanya menghasilkan teks. Tanpa harness, model bisa menjawab pertanyaan, tapi tidak bisa menjalankan kode, memanggil API, membaca file, mengingat pekerjaan sebelumnya, atau menyelesaikan workflow multi-langkah. Harness pula yang memungkinkan pencatatan progres dipindahkan ke lingkungan software terstruktur, alih-alih memaksa model membaca ulang transkrip yang terus membengkak di dalam context window.
Untuk satu kali tanya-jawab, harness memang tidak diperlukan. Ia baru jadi penentu ketika tugasnya multi-langkah, banyak tool, atau berjalan lama lintas sesi.
Rumus Agent = Model + Harness
AI Security Institute di Inggris sudah menggambarkan agent sebagai gabungan model dan scaffolding sejak 2023. Hubungan itu kini diringkas dalam satu rumus sederhana:
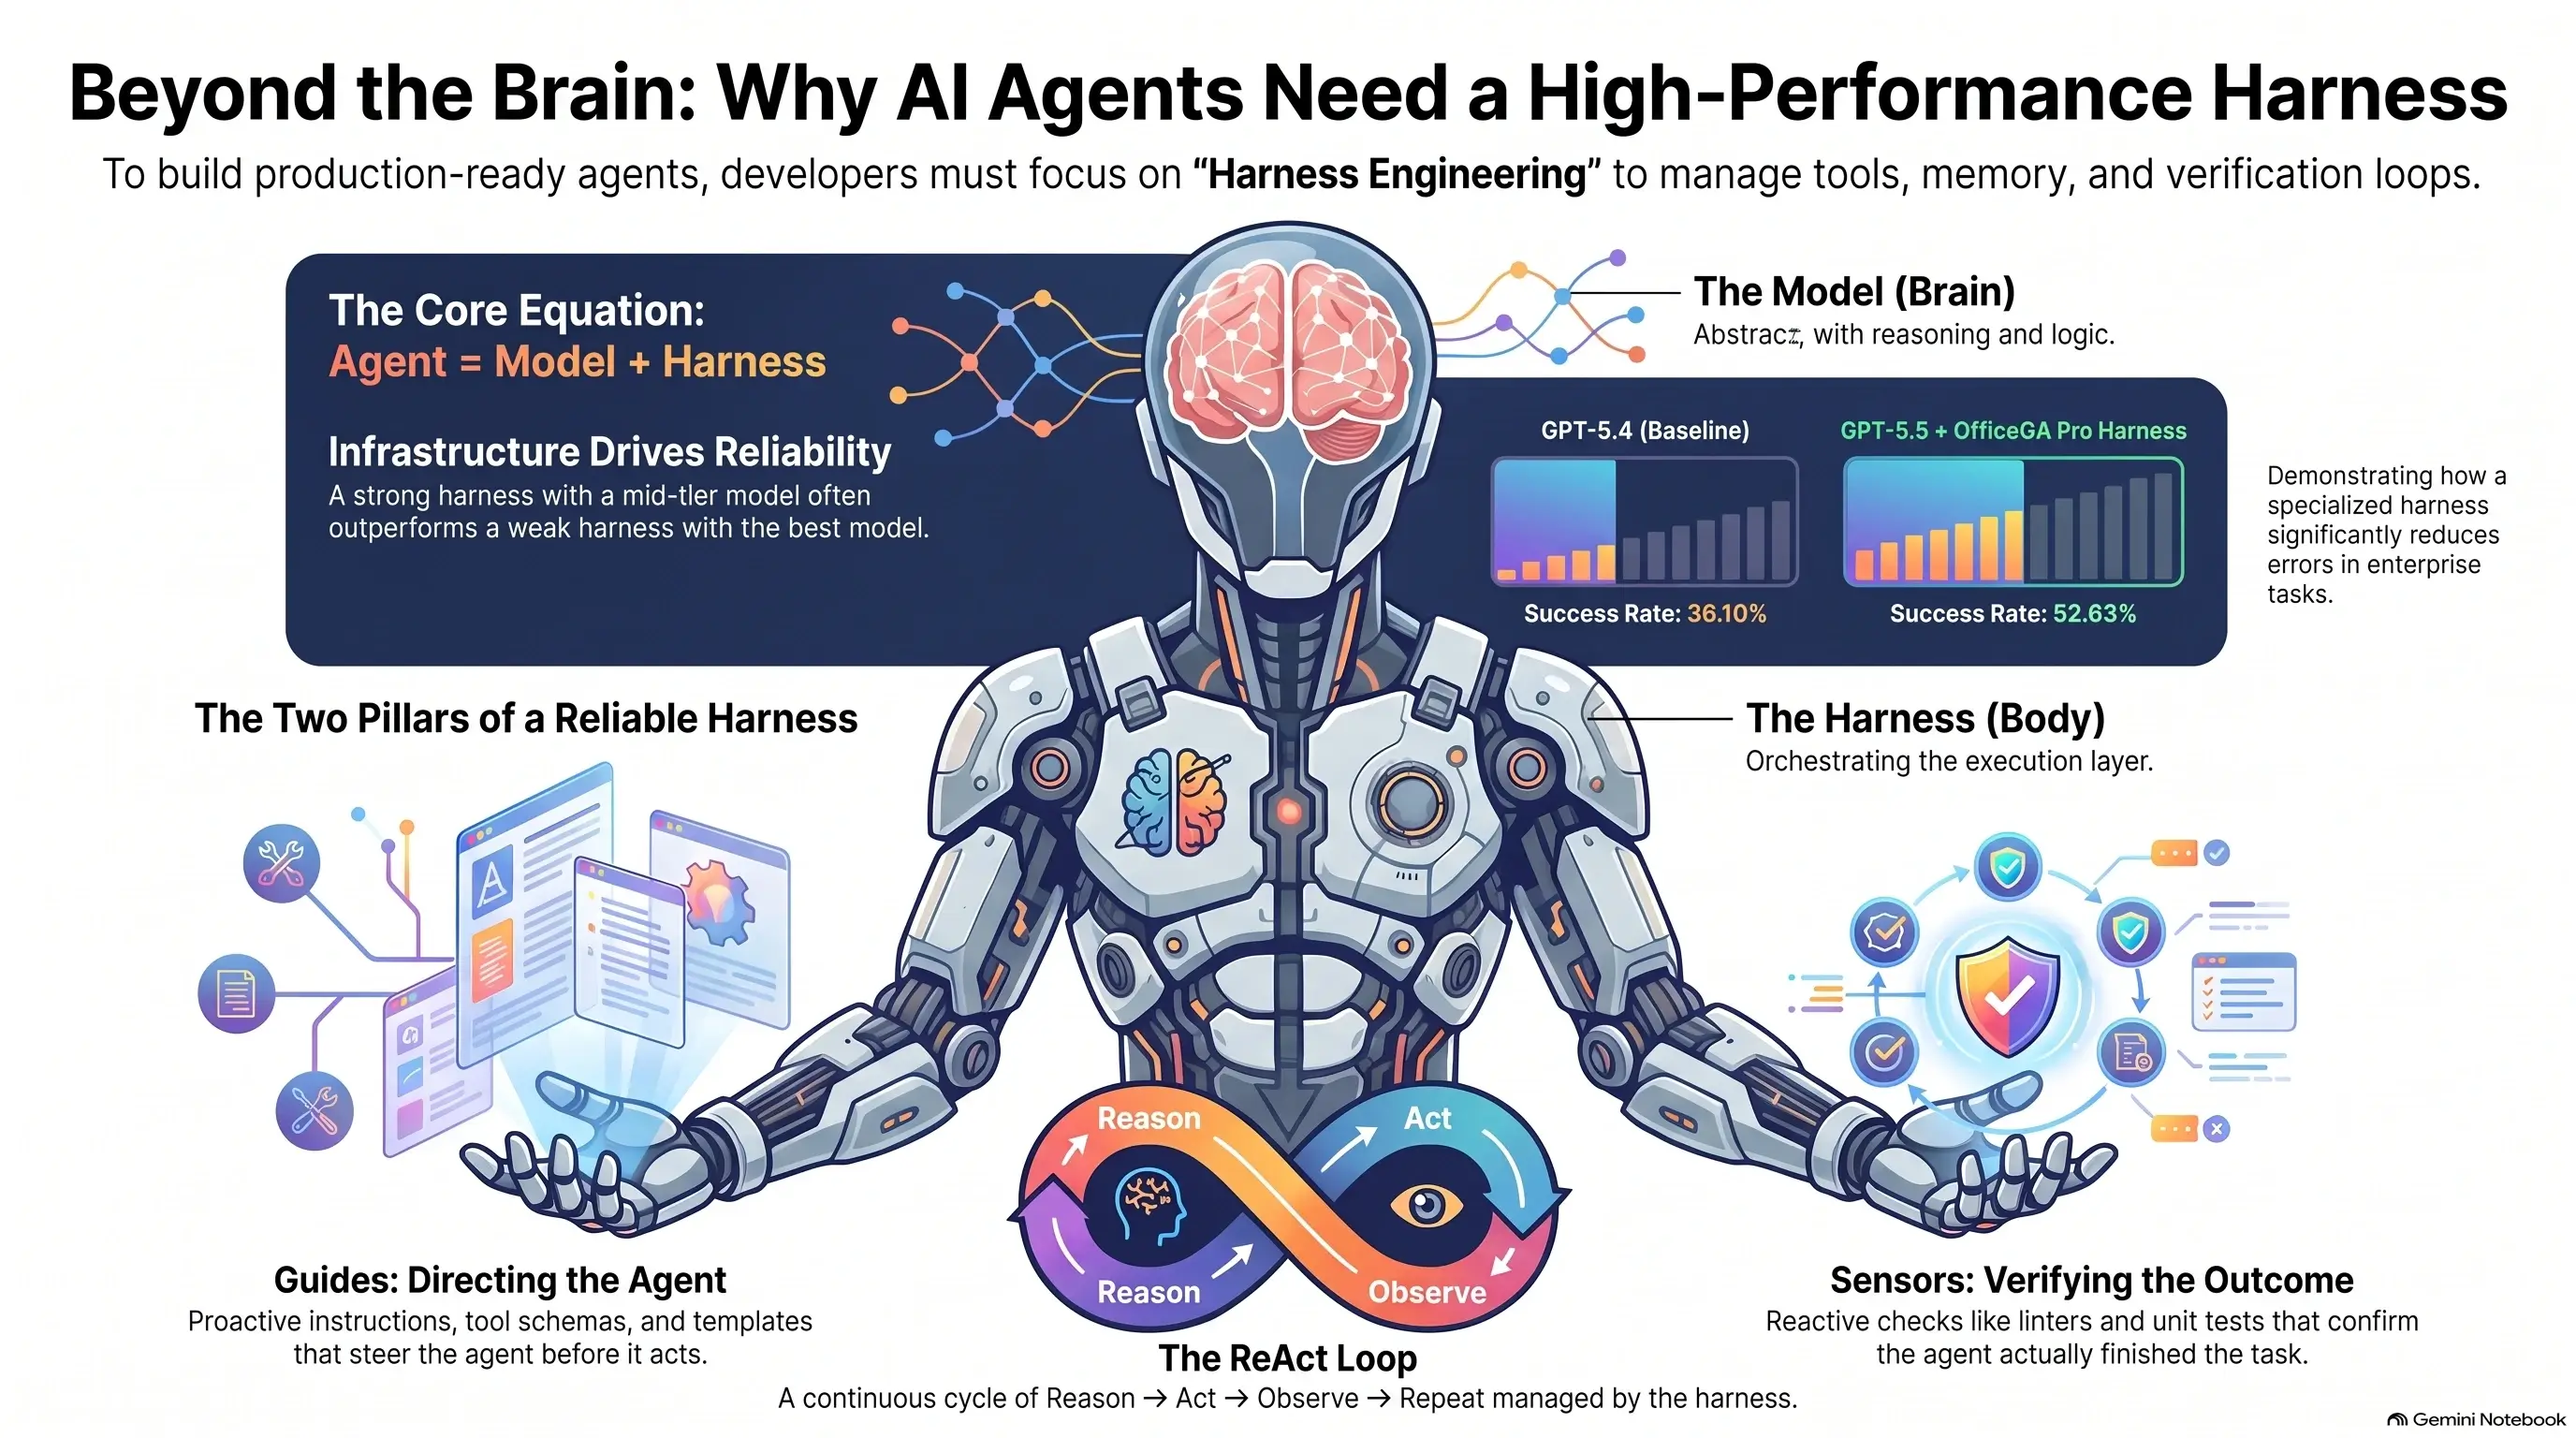
agent = model + harness
Analogi yang paling mudah dicerna: model adalah otak, harness adalah tubuh dan ruang kerja di sekelilingnya, dan agent adalah pekerja utuh yang bisa berpikir sekaligus bertindak.
| Komponen | Perannya | Analogi |
|---|---|---|
| Model | Bernalar, memprediksi, menghasilkan output | Otak |
| Harness | Mengeksekusi aksi, mengelola memory, menjalankan tool, menegakkan aturan | Tubuh dan ruang kerja |
| Agent | Sistem utuh hasil gabungan keduanya | Pekerja yang bisa berpikir dan bertindak |
Di inti banyak agent ada siklus berulang: reason → act → observe → repeat. Model membaca konteks dan memutuskan aksi; harness menjalankan aksi itu (tool, sandbox, API, storage); harness menangkap hasilnya dan mengembalikannya sebagai konteks baru; lalu siklus berlanjut sampai tugas selesai. Pola ini dikenal sebagai ReAct loop, diperkenalkan lewat paper ReAct pada 2022.
Delapan Komponen Harness Produksi
Hampir semua harness yang dipakai serius dibangun dari komponen yang sama, masing-masing menambal satu keterbatasan model mentah.
| Komponen | Fungsi |
|---|---|
| System prompt | Instruksi tetap: siapa agent ini, tujuannya apa, aturannya apa |
| Tools dan tool execution | Fungsi yang bisa dipanggil model; harness yang benar-benar menjalankannya |
| Sandbox | Ruang terisolasi untuk menjalankan kode tanpa merusak sistem nyata |
| Filesystem dan storage | Tempat menulis kode, catatan, dan hasil kerja yang bertahan antar sesi |
| Memory dan context management | Kompaksi, ringkasan, serta penyimpanan riwayat lintas sesi |
| Feedback loop dan self-verification | Menjalankan test atau memeriksa hasil sebelum agent lanjut |
| Guardrail dan human-in-the-loop | Izin, kebijakan, dan titik persetujuan manusia untuk aksi berisiko |
| Observability dan logging | Log, trace, dan audit trail untuk debugging serta kepatuhan |
Kenapa Keandalan Ditentukan Harness, Bukan Model
Seiring kemampuan mentah antar model makin konvergen, harness-lah yang makin menentukan performa akhir. Pada benchmark publik, model yang persis sama bisa menempati peringkat jauh berbeda semata-mata karena desain harness-nya. Untuk tugas yang berat di sisi workflow, harness kuat di atas model kelas menengah sering mengalahkan harness lemah di atas model terkuat.
Dampaknya terukur. Ketika Databricks memasangkan GPT-5.5 dengan OfficeQA Pro Agent Harness yang dirancang untuk tugas dokumen enterprise multi-bagian, skornya naik ke 52,63 persen dari 36,10 persen pada GPT-5.4 — error terpangkas hampir separuh. Modelnya memang membaik, tetapi harness yang membuat perbaikan itu diterjemahkan menjadi performa produksi yang stabil.
Sebaliknya, pola kegagalan yang paling sering ditemui di produksi juga bersumber dari harness: context rot saat riwayat percakapan membengkak, tool overload karena terlalu banyak tool disodorkan sekaligus, wiring tool yang rapuh sehingga gagal secara senyap, latensi tinggi akibat rantai tool call yang panjang, retrieval yang tidak relevan, verifikasi lemah sehingga agent berhenti terlalu dini, dan guardrail yang absen saat agent melakukan aksi yang tidak bisa dibatalkan.
Satu ciri khas membedakan harness dari scaffolding software biasa: komponen yang dibungkus bersifat non-deterministik. Karena itu harness harus dirancang untuk pulih dengan anggun ketika model mengarang aksi atau melaporkan tugas selesai padahal belum.
Inner Harness vs Outer Harness
Birgitta Böckeler dari Thoughtworks membedakan dua lapisan yang penting dipahami sebelum tim memutuskan apa yang perlu dibangun sendiri.
Inner harness adalah harness bawaan dari pembuat model: agent SDK resmi, atau coding tool seperti Cursor dan Codex. Ini bagian yang tidak kita kontrol; kita memilihnya, bukan membangunnya.
Outer harness adalah lapisan yang kita rakit sendiri di atasnya: instruction file di repositori, MCP (Model Context Protocol) server untuk menghubungkan agent ke sistem internal, serta custom skill untuk workflow spesifik. Di sinilah sebagian besar pekerjaan tim engineering sebenarnya berada, dan di sinilah keunggulan kompetitif dibangun.
Pembagian ini juga praktis untuk debugging. Kalau agent salah memakai tool bawaan, itu urusan inner harness dan biasanya diselesaikan dengan mengganti versi atau konfigurasi. Kalau agent tidak tahu konvensi kode proyek Anda, itu murni kegagalan outer harness.
Guides vs Sensors: Mengarahkan dan Memverifikasi
Böckeler juga memisahkan dua peran berbeda di dalam harness:
Guides mengarahkan agent sebelum ia bertindak.
Sensors mengamati hasil setelah aksi dilakukan, sehingga agent bisa mengoreksi dirinya sendiri.
Keduanya bisa bersifat komputasional (pemeriksaan deterministik seperti linter atau test) maupun inferensial (pemeriksaan semantik seperti LLM as judge).
| Komputasional | Inferensial | |
|---|---|---|
| Guides (sebelum aksi) | Template proyek, schema tool, type definition | Instruction file, deskripsi tool, contoh naratif |
| Sensors (setelah aksi) | Linter, unit test, type checker, smoke test HTTP | LLM as judge, review semantik terhadap diff |
Kesalahan umum tim pemula adalah menumpuk guides saja — menulis instruction file sepanjang ribuan baris — tanpa sensor apa pun. Hasilnya agent tetap percaya diri melaporkan sukses. Kombinasi keduanya jauh lebih efektif daripada memperbanyak salah satu.
Pelajaran dari Harness untuk Agent Berjalan Lama
Anthropic mendokumentasikan satu contoh konkret yang layak ditiru. Tantangan utama agent berjalan lama adalah setiap sesi dimulai tanpa ingatan atas sesi sebelumnya — seperti proyek software yang dikerjakan bergiliran oleh engineer yang selalu baru datang dan tidak tahu apa yang terjadi di shift sebelumnya. Kompaksi context saja ternyata tidak cukup.
Dua pola kegagalan muncul. Pertama, agent berusaha menyelesaikan semuanya sekaligus, kehabisan context di tengah implementasi, dan meninggalkan fitur setengah jadi tanpa dokumentasi. Kedua, agent di sesi berikutnya melihat sudah ada progres lalu menyatakan pekerjaan selesai.
Solusinya dua lapis. Initializer agent menyiapkan lingkungan pada sesi pertama: script init.sh untuk menjalankan development server, file progres claude-progress.txt, commit git awal, serta daftar fitur terstruktur dalam bentuk JSON — pada contoh mereka lebih dari 200 fitur, semuanya ditandai passes: false sejak awal. Format JSON sengaja dipilih karena model lebih kecil kemungkinannya menimpa atau mengubahnya sembarangan dibanding file Markdown.
Coding agent di setiap sesi berikutnya diminta membaca pwd, log git, file progres, dan daftar fitur; memilih satu fitur berprioritas tertinggi yang belum selesai; mengerjakannya sampai tuntas; memverifikasinya secara end-to-end lewat browser automation seperti Puppeteer MCP; lalu menutup sesi dengan commit deskriptif dan pembaruan catatan progres. Agent dilarang keras menghapus atau mengedit test, karena itu bisa menyembunyikan fungsionalitas yang rusak.
Perhatikan bahwa hampir semua perbaikan di atas bersifat lingkungan, bukan prompt. Itulah inti harness engineering.
Apa yang Kami Bangun di Layer Harness untuk Klien
Di katili.dev, ketika klien meminta agent internal untuk operasional website atau workflow bisnis, model bukan bagian yang paling banyak kami kerjakan. Fokusnya justru di outer harness:
Instruction file per repositori. Konvensi penamaan, struktur folder Laravel, aturan migrasi database, dan larangan menyentuh direktori tertentu ditulis eksplisit sebagai guides.
MCP server internal. Agent diberi akses terkontrol ke log staging, status layanan hosting, dan query read-only ke database — bukan kredensial mentah.
Custom skill untuk workflow berulang. Contohnya skill impor artikel blog multi-bahasa, checklist migrasi WordPress ke Laravel, dan prosedur setup domain serta SSL.
Sensors berlapis. Setiap perubahan kode melewati linter dan static analysis, unit test, lalu smoke test HTTP terhadap environment staging setelah deploy. Agent tidak boleh menyatakan tugas selesai sebelum sensor ini hijau.
Guardrail dan human-in-the-loop. Migrasi database produksi, perubahan DNS, dan penghapusan file wajib melewati persetujuan manusia.
Progress file dan konvensi commit. Sama seperti pola initializer dan coding agent di atas, sehingga sesi berikutnya tidak perlu menebak-nebak.
Observability. Setiap tool call dicatat agar bisa diaudit dan di-debug ketika hasilnya menyimpang.
Hasil praktisnya: ketika klien ingin mengganti model — karena harga, latensi, atau ketersediaan regional — seluruh lapisan di atas tetap dipakai ulang. Itu keuntungan nyata dari memperlakukan harness sebagai aset, bukan sebagai sisa-sisa kode di sekitar prompt.
Penutup
Harness engineering adalah lapisan yang lebih luas daripada prompt engineering, yang mengoptimalkan satu interaksi, dan lebih luas daripada context engineering, yang mengatur informasi apa yang dilihat model pada satu momen. Harness merancang keseluruhan lingkungan operasional, dan keduanya berada di dalamnya sebagai bagian.
Model akan terus membaik, dan sebagian pekerjaan harness kemungkinan akan bergeser ke dalam model itu sendiri. Tetapi lingkungan eksekusi, orkestrasi tool, guardrail, observability, dan feedback loop tetap yang menentukan apakah sebuah model bisa beroperasi andal di sistem nyata. Harness yang kuat membuat model biasa menjadi berguna; harness yang lemah menyia-nyiakan model terbaik sekalipun.
Kalau tim Anda sedang mulai membangun AI agent, ukur kematangannya bukan dari nama model yang dipakai, tapi dari jawaban atas pertanyaan ini: apa guides-nya, apa sensors-nya, dan apa yang terjadi ketika agent salah?